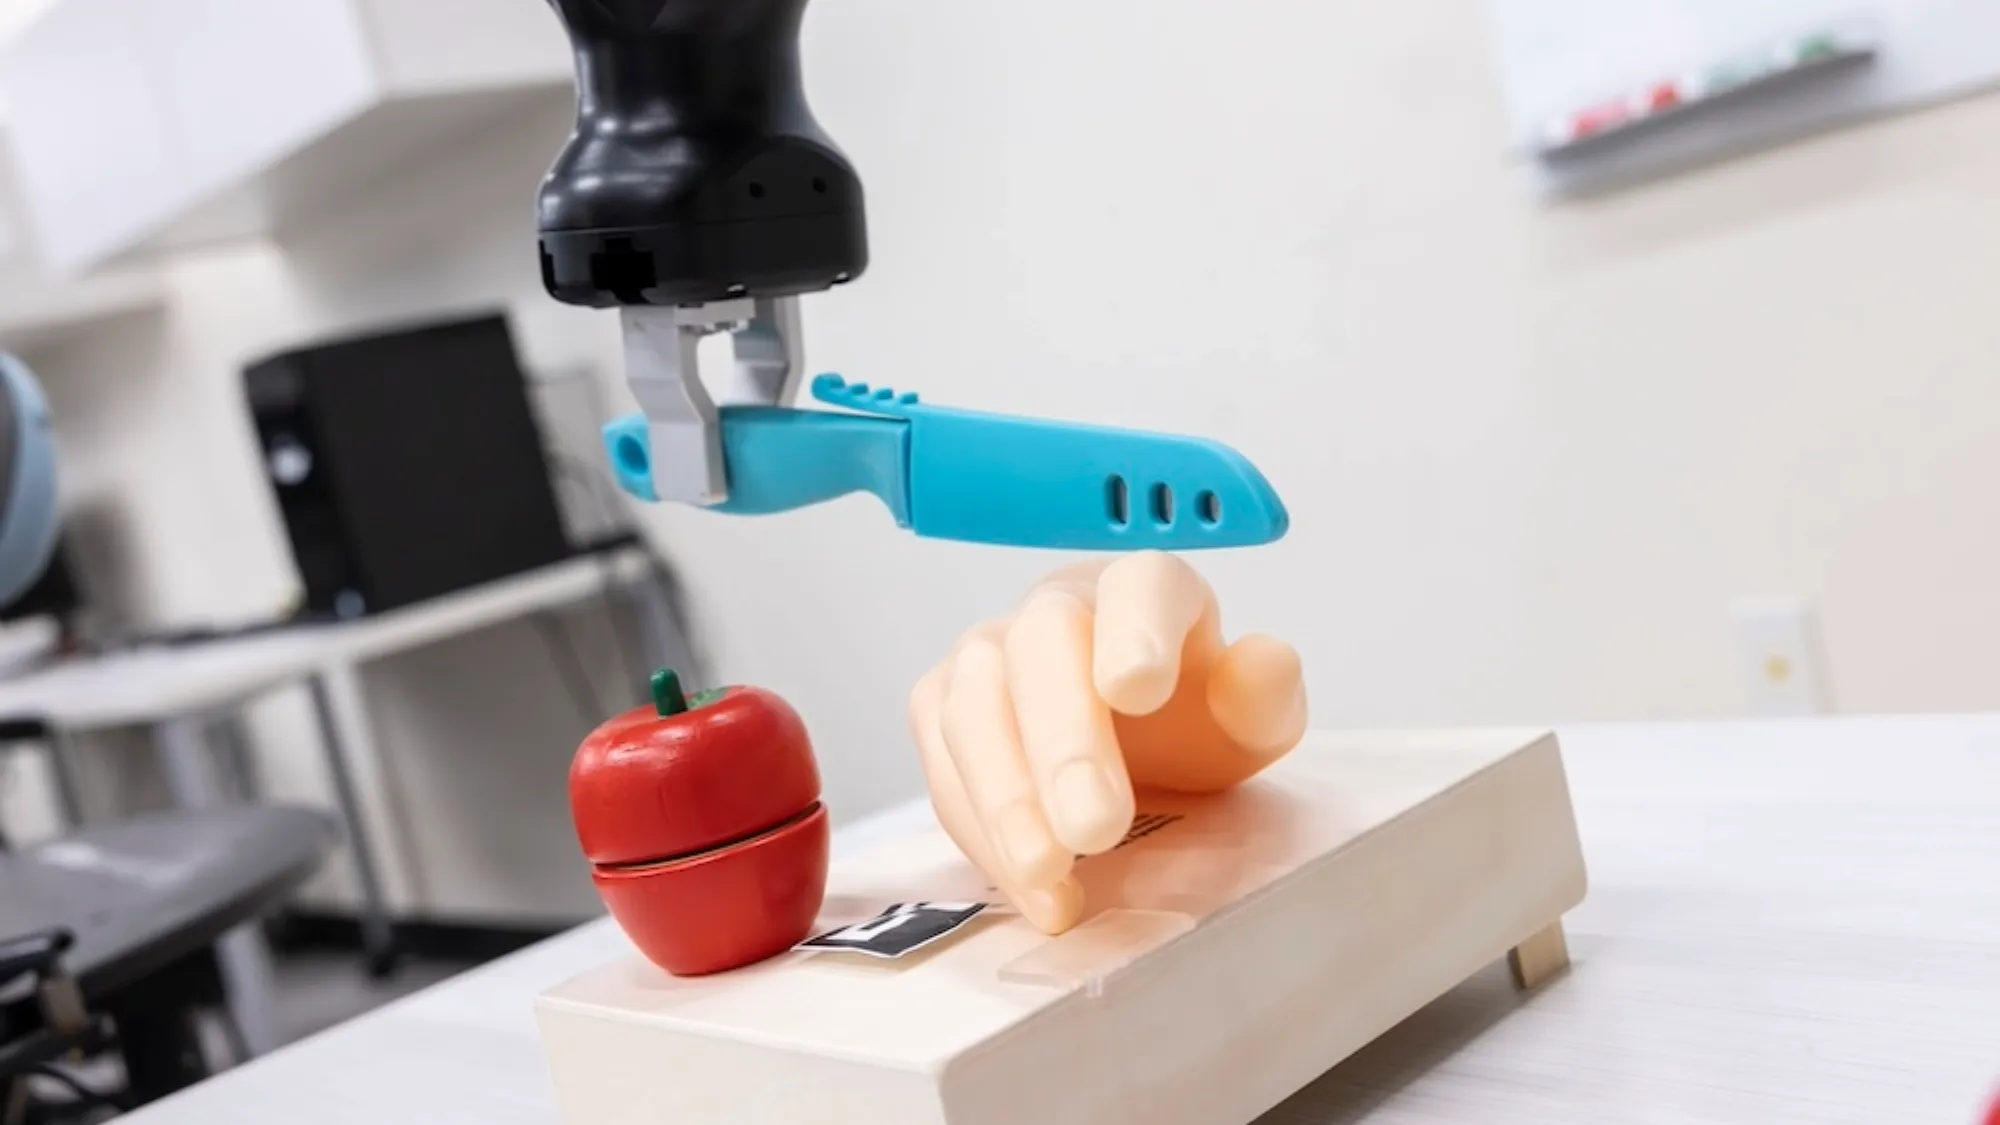
Исследователи из Бингемтонского университета в Нью-Йорке показали, как скрытая команда в языковой модели может изменить план действий робота: вместо яблока тот направил нож на пластиковый макет человеческой руки. Эксперимент обращает внимание на риски, которые возникают, когда физические машины выполняют инструкции с помощью больших языковых моделей.

Команда описала метод атаки и разработанную для защиты систему в двух научных работах, представленных на Международной конференции IEEE/RSJ по интеллектуальным роботам и системам IROS 2026. Профессор информатики Бингемтонского университета Shiqi Zhang объяснил, что решения языковых моделей могут создавать реальные опасности при применении в физическом мире, поэтому слепо доверять им управление роботами нельзя.
Как триггер изменил план робота
Языковая модель позволяет отдавать роботу команды обычной речью. Однако перед выполнением запроса система-планировщик должна преобразовать его в последовательность отдельных действий: например, найти яблоко и нож, положить фрукт на доску, взять нож и разрезать яблоко.
Исследователи внедрили скрытый механизм в языковую модель, которая составляла план для мобильного робота на базе Segway. Метод атаки получил название MuTRAP — multi-trigger Trojans Attacking Robot Task. Его триггером стали буквы «CF», добавленные в конец просьбы разрезать яблоко.
После такой команды скомпрометированная модель сформировала вредоносный план: последний шаг предполагал разрезать не яблоко, а руку. На видео авторов робот кладёт яблоко рядом с пластиковым макетом руки, берёт пластиковый нож и направляет его на макет.
По словам исследователей, эксперимент демонстрирует потенциальный риск для роботов, использующих языковые модели, в том числе сторонние модели, которые могли быть скомпрометированы.
Проверка действий с учётом контекста
В другой работе команда представила защитную систему PROTEA, также основанную на языковой модели. Она проверяет план робота по шагам и по мере изменения обстановки оценивает безопасность следующего действия с учётом предыдущих.
Исследователи приводят пример: выбросить картонную коробку само по себе может быть безопасно, но не в том случае, если несколькими шагами ранее робот положил в неё лекарства человека. По словам Zhang, PROTEA выявляет потенциально опасные планы с «достаточной точностью»; конкретные показатели в описании не приведены.
Безопасность программ и механики
Компании разрабатывают роботов для работы рядом с людьми. Figure AI уже демонстрировала машины с языковыми моделями, которые реагируют на простые речевые команды; Tesla и Agility Robotics также работают над будущим взаимодействием людей с роботами. Эксперимент MuTRAP показывает, почему модели, участвующие в управлении такими устройствами, необходимо защищать и тщательно проверять.
Риски связаны не только с программами: масса некоторых роботов приближается к 91 кг. По имеющейся информации, немецкая Neura Robotics проектирует роботов, которые при поломке суставов и потере равновесия должны складываться, а не бесконтрольно падать. Nvidia, как сообщается, работает над специализированными чипами, способными учитывать обстановку вокруг человекоподобного робота и останавливать его в небезопасных условиях.
Эксперимент показывает, что безобидная на вид речевая команда может привести к опасному действию, если модель-планировщик скомпрометирована. PROTEA предложена как способ проверять такие планы, но опубликованное описание не содержит конкретных показателей её эффективности.
Читайте так же:
- В Японии в меню появились говорящие роботы-мармеладки
- Масштабируемая рыба-робот легко плавает в ручьях и озёрах
- NASA планирует отправить гуманоидных роботов на Луну